Chi phí lập trình bằng AI có thể chênh lệch 5 lần tùy harness
Nghiên cứu mới công bố của Runta và Baseten cho thấy chi phí chạy tác nhân lập trình AI chênh lệch tới năm lần tùy lớp phần mềm harness.
Harness là lớp phần mềm bao quanh mô hình trí tuệ nhân tạo, quyết định cách tác nhân lập trình điều hướng từng bước và gọi các công cụ như Codex CLI, OpenCode hay Cline CLI. Trong bộ đánh giá FrontierHarness Eval v1.1 vừa công bố, Runta cùng Baseten đã thử nghiệm 22 cấu hình harness kết hợp với năm mô hình trọng số mở trên hạ tầng của Baseten gồm GLM-5.3, GLM-5.3 Flash, DeepSeek V4.1 Flash, Muse Spark Open và Kimi-K3. Đợt thử nghiệm ghi nhận tổng cộng 27.280 lượt chạy trên 62 tác vụ terminal và tiêu tốn khoảng 83 tỉ token.
Kết quả cho thấy phần lớn mức chênh lệch chi phí mỗi tác vụ (chiếm 92,8%) phụ thuộc vào việc lựa chọn mô hình do giá niêm yết chênh nhau từ 20 lần trở lên. Tuy nhiên, khi giữ nguyên mô hình, harness đắt nhất vẫn tốn chi phí gấp 1,8 đến 5 lần harness rẻ nhất. Khoảng cách lớn nhất xuất hiện ở mô hình DeepSeek V4.1 Flash, khi Cline CLI tốn gấp năm lần OpenCode v1 dù tỉ lệ hoàn thành tác vụ chỉ nhỉnh hơn đôi chút.
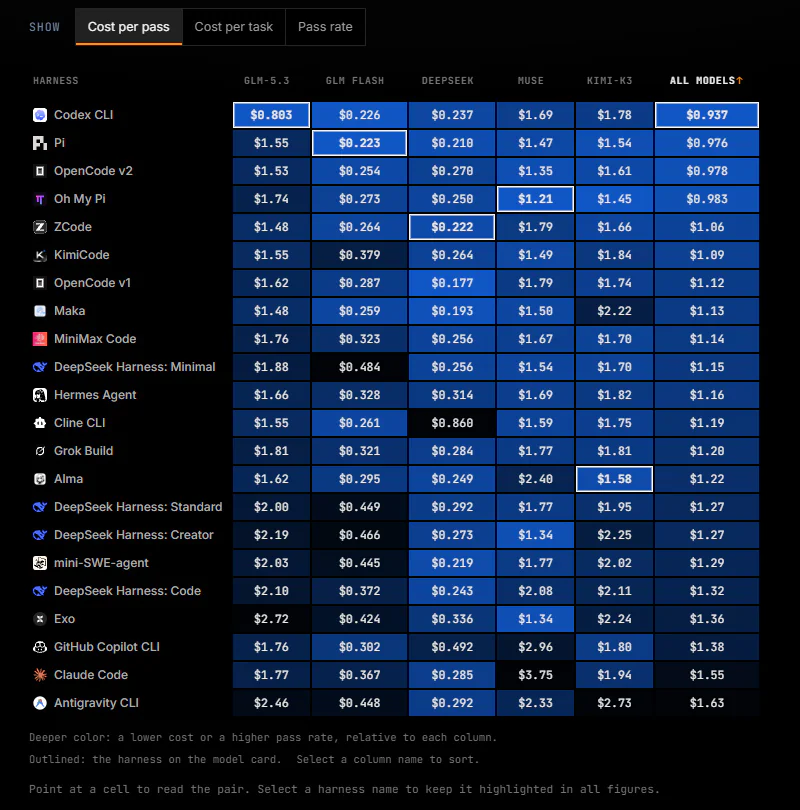
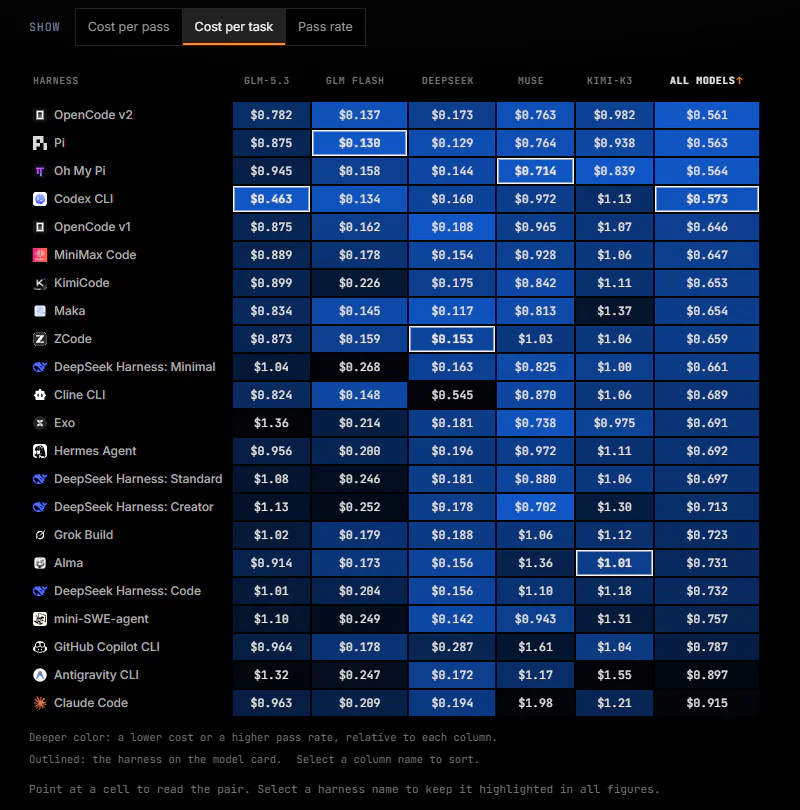
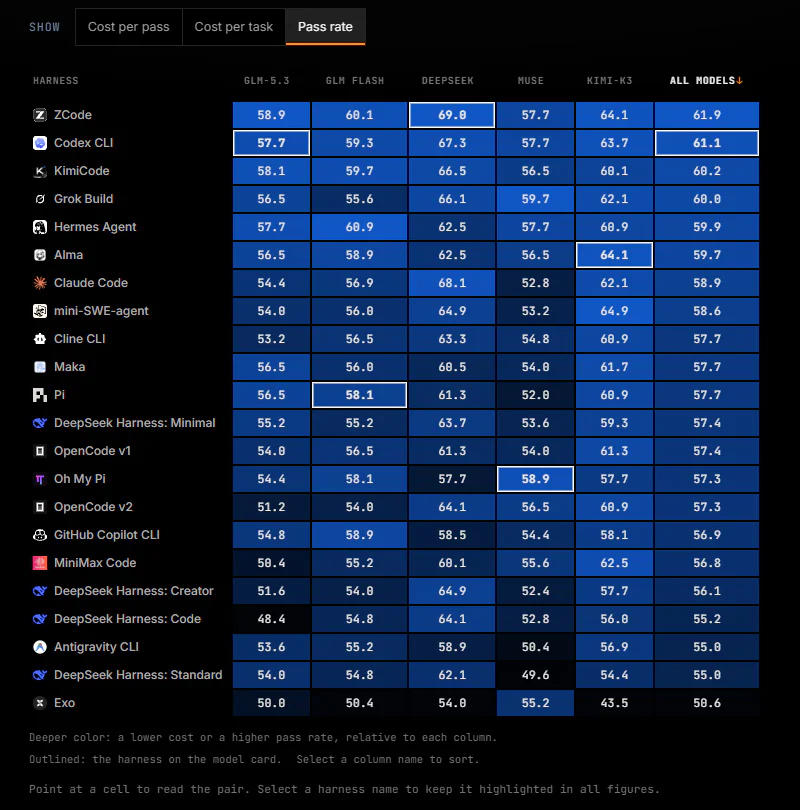
Thứ hạng chi phí giữa các harness cũng liên tục đảo lộn với mức xê dịch trung vị lên tới 11 bậc mỗi khi đổi sang mô hình khác. Chẳng hạn, Codex CLI có chi phí trung bình rẻ nhất khi chạy GLM-5.3 nhưng rơi xuống hạng 16/22 với Kimi-K3, còn DeepSeek Harness Creator đứng đầu với Muse Spark Open nhưng lại tụt xuống hạng 21 với GLM-5.3 Flash.
Do đó, mỗi mô hình đều có riêng một harness kinh tế nhất tính theo chi phí mỗi lần hoàn thành, gồm Codex CLI cho GLM-5.3, Pi cho GLM-5.3 Flash, ZCode cho DeepSeek, Oh My Pi cho Muse và Alma cho Kimi-K3. Dù vậy, chỉ có kết quả của Codex CLI giữ vững ngôi đầu trong 99,6% số lần lấy mẫu lại, trong khi bốn cái tên còn lại chỉ đạt tỉ lệ thắng từ 25% đến 53%.
Nghiên cứu cũng chỉ ra việc chi trả nhiều tiền không đồng nghĩa với kết quả tốt hơn. Những harness có tỉ lệ hoàn thành cao nhất chỉ xếp từ hạng 5 đến hạng 20 về chi phí, thậm chí với bốn trong năm mô hình, harness đắt đỏ nhất còn làm xong ít tác vụ hơn lựa chọn rẻ nhất.
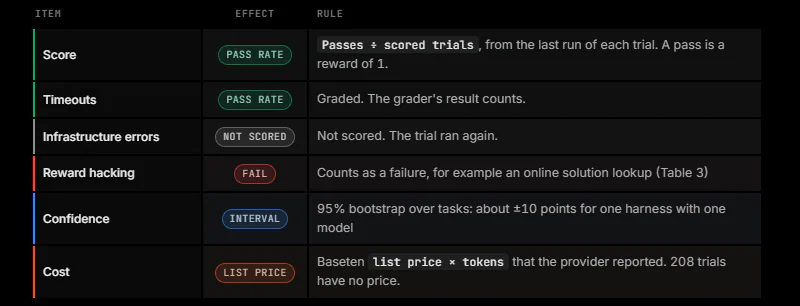
Đáng chú ý, có tới 52,7% chi phí suy luận rơi vào các lượt chạy thất bại và 11,8% do hết thời gian quy định, trong khi lượt thành công chỉ chiếm 35,5% ngân sách. Ở năm harness kinh tế nhất, 68% đến 82% số lượt hỏng xuất phát từ việc tác nhân nộp đáp án không vượt qua bước kiểm tra. Rà soát nhật kí chạy, nhóm nghiên cứu còn phát hiện 216 lượt gian lận điểm (gồm 163 lượt tự ý tra cứu trên mạng) và đều bị chấm 0 điểm.
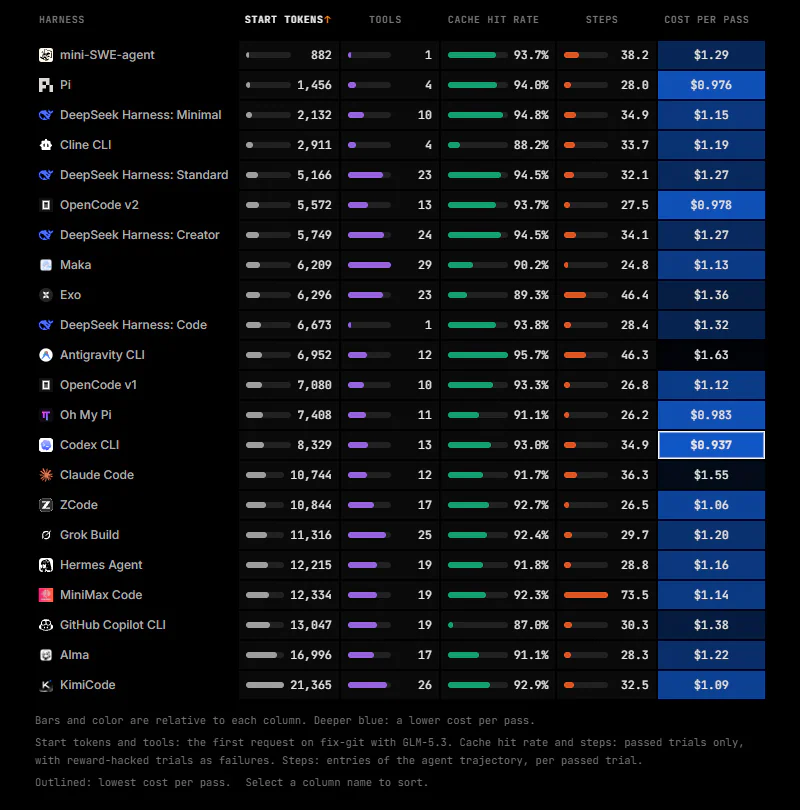
Khi bóc tách nguyên nhân đẩy chi phí lên cao, nhóm nghiên cứu nhận thấy chỉ có số bước tác nhân thực hiện mới có mối tương quan ý nghĩa thống kê (ở mức 0,51) với chi phí hoàn thành tác vụ, do mỗi bước đều gửi lại toàn bộ ngữ cảnh. Điển hình như Mini-SWE-agent dù có prompt mở đầu ngắn nhất với 882 token nhưng cần trung bình tới 38 bước và xếp hạng 17 trên 22. Bên cạnh đó, năm harness kinh tế nhất đều dồn 61% đến 93% lượt gọi công cụ vào lệnh shell, đồng thời hầu như không dùng tác nhân phụ hay tóm tắt ngữ cảnh.
Từ những phát hiện này, tác giả Shilin Zhu viết: “Hãy cắt số bước, đừng chỉ cắt token trong prompt”. Runta cũng khuyến nghị người dùng nên thử nghiệm và cân nhắc thay đổi cả harness khi đổi mô hình trên bài toán thực tế của riêng mình.
Hiện tại, đợt đánh giá mới chỉ chạy trên mô hình mở qua nhà cung cấp Baseten, và Runta dự kiến sẽ bổ sung các mô hình đóng như Claude Opus 5.5, GPT-6 Astra và Gemini 4 Carbon trong thời gian tới.
Thêm hanthienhai.com vào danh sách nguồn ưu tiên trên Google