
Microsoft hoàn tất tiền huấn luyện mô hình MAI-Base-2
Microsoft AI vừa hoàn tất tiền huấn luyện MAI-Base-2, mô hình nền 2,8 nghìn tỉ tham số mà hãng cho biết vượt mọi mô hình trọng số mở trong thử nghiệm.
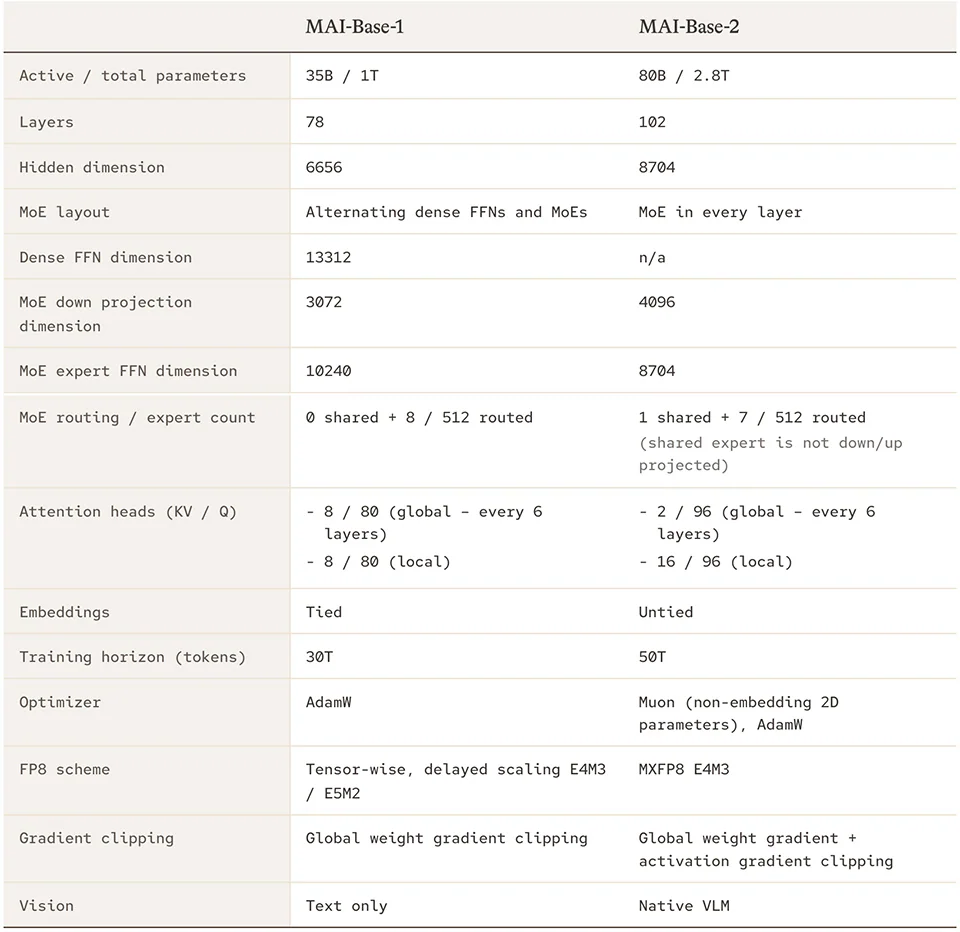
Theo bài viết trên trang microsoft.ai, MAI-Base-2 là mô hình hỗn hợp chuyên gia (Mixture of Experts, MoE) với 80 tỉ tham số hoạt động trên tổng số 2,8 nghìn tỉ tham số. Microsoft huấn luyện mô hình trên 16.000 GPU GB200 trong 38 ngày, rải qua tháng 08 và tháng 09/2026. Đây là bản kế nhiệm MAI-Base-1, mô hình nền của MAI-Thinking-1 mà hãng công bố hồi tháng 06/2026.
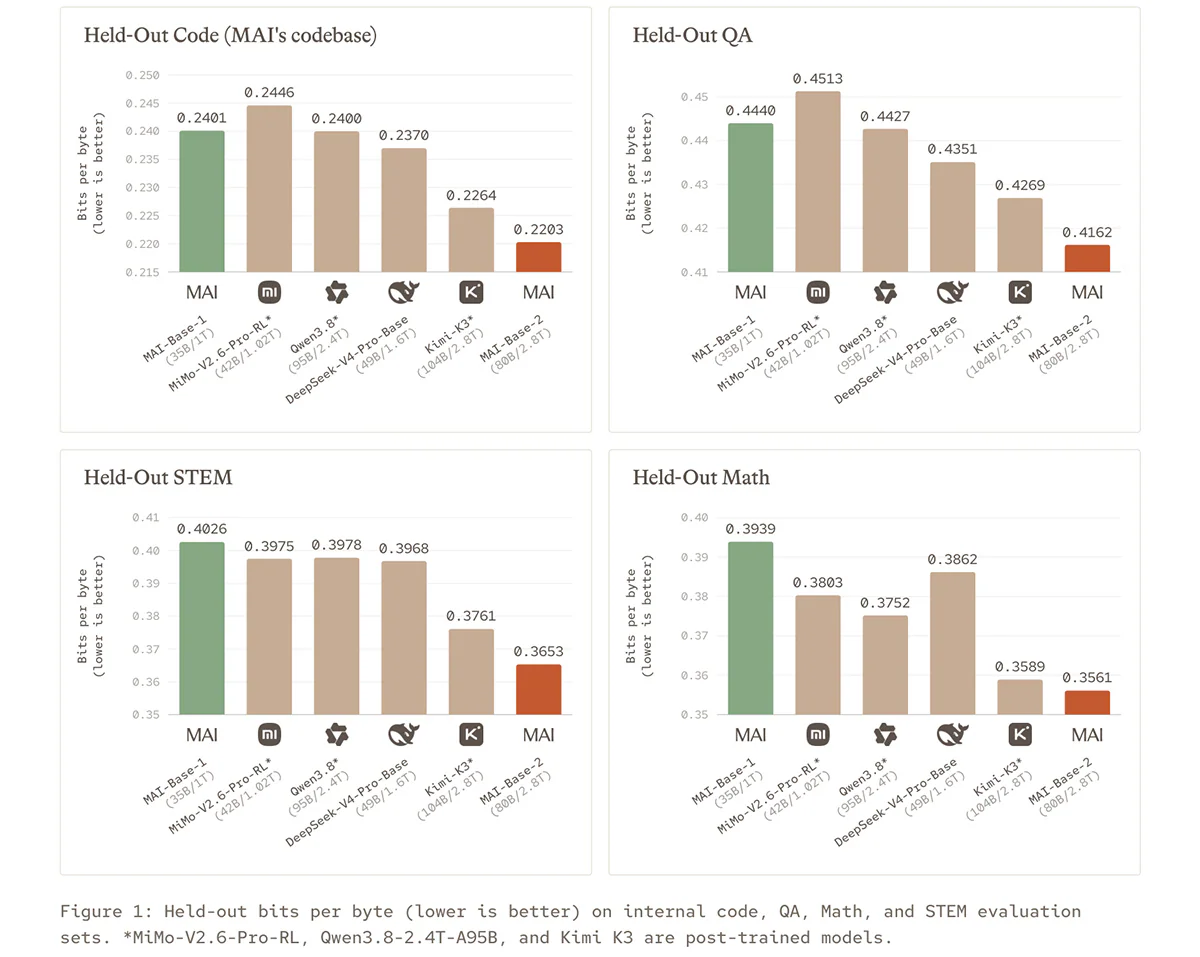
Hãng so sánh MAI-Base-2 với DeepSeek-V4-Pro-Base, Kimi K3, Qwen3.8-2.4T-A95B và MiMo-V2.6-Pro-RL trên bốn bộ đề lập trình, hỏi đáp, STEM và toán. Bộ đề lập trình lấy từ chính kho mã của Microsoft AI, ba bộ còn lại do đối tác bên ngoài soạn nhằm giảm nguy cơ mô hình đã gặp đề trong lúc học. MAI-Base-2 đạt kết quả tốt nhất ở cả bốn bộ, dù hãng lưu ý ba mô hình sau chỉ có bản đã qua hậu huấn luyện nên kết quả có thể bị ảnh hưởng.
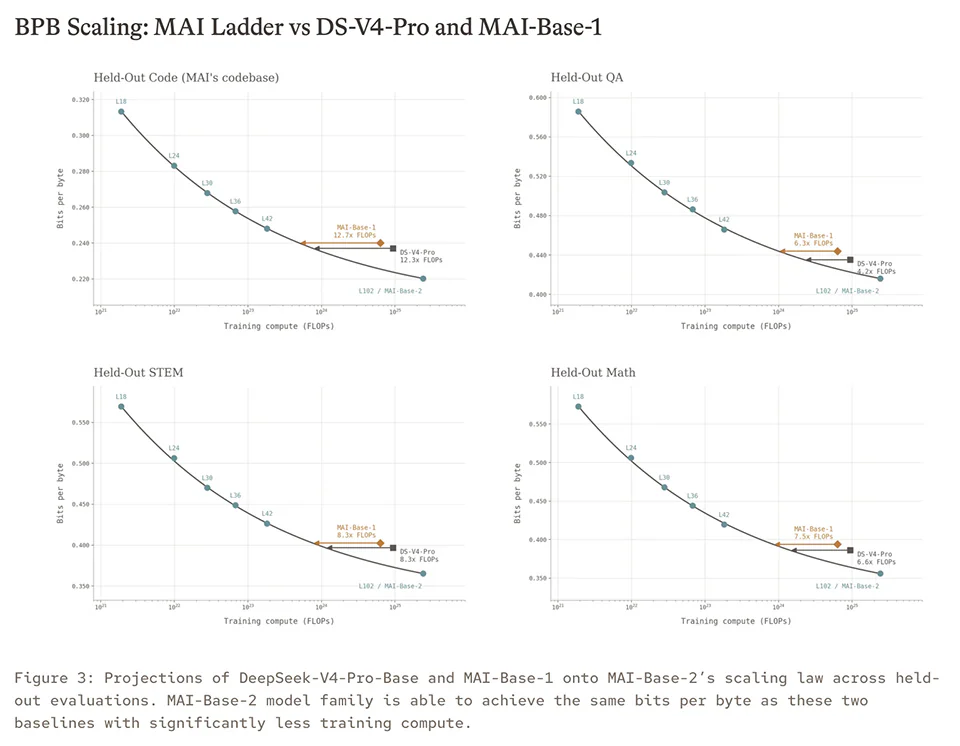
Theo ước tính của Microsoft AI, công thức huấn luyện của MAI-Base-2 tốn ít tài nguyên tính toán hơn từ 4,2 đến 12,3 lần để đạt hiệu năng ngang DeepSeek-V4-Pro-Base, mô hình nền trọng số mở mạnh nhất hiện có. So với MAI-Base-1, mức cải thiện là từ 6,3 đến 12,7 lần. Phần tài nguyên tiết kiệm được sẽ được dùng để huấn luyện một mô hình lớn hơn.
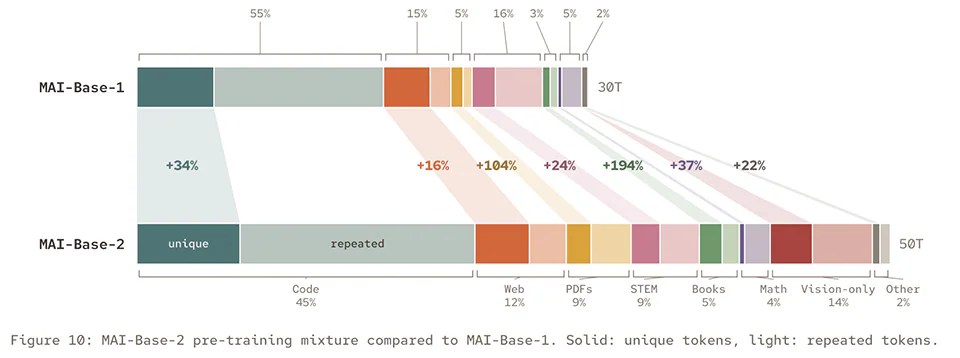
Dữ liệu huấn luyện tăng từ 30 nghìn tỉ lên 50 nghìn tỉ token, số token không trùng lặp tăng khoảng 36%, với mốc cập nhật kiến thức tháng 03/2026. Khác bản tiền nhiệm chỉ học văn bản, MAI-Base-2 học hình ảnh ngay từ đầu theo kiến trúc mô hình thị giác ngôn ngữ (VLM) không cần bộ mã hóa riêng. Dữ liệu hình ảnh chiếm 18% hỗn hợp huấn luyện, gồm đọc biểu đồ, suy luận không gian, hiểu ảnh y khoa, thao tác máy tính và cả đọc bản nhạc.
Microsoft nhấn mạnh mọi token huấn luyện đều do hãng tự xử lí từ dữ liệu gốc, không trích xuất năng lực từ mô hình khác (distillation). Trình thu thập web của hãng tuân thủ robots.txt và loại các nguồn nằm trong danh sách thị trường khét tiếng (Notorious Markets) của Văn phòng Đại diện Thương mại Hoa Kỳ. Theo Microsoft AI, nhờ nắm rõ nguồn gốc dữ liệu, họ có thể cấp phép trọng số mô hình cho các đối tác tin cậy qua nền tảng Foundry.
Về kĩ thuật, nhóm phát triển nêu ba yếu tố chính: “thang mở rộng” gồm các mô hình nhỏ dùng chung công thức để dự báo kết quả của mô hình lớn, thiết kế mô hình song song với hạ tầng, và mở rộng dữ liệu. Sau khi gỡ hai điểm nghẽn, hiệu suất sử dụng phần cứng của các lớp MoE tăng từ 24% lên 35%, đủ để đặt MoE ở mọi lớp thay vì xen kẽ như MAI-Base-1. Microsoft AI cũng chuyển sang bộ tối ưu Muon và cắt gradient kích hoạt, giúp quá trình huấn luyện ổn định hơn. Kĩ thuật thứ hai còn giúp nhóm lần ra một lỗi trong khâu tiền xử lí dữ liệu mã nguồn.
MAI-Base-2 hiện trong giai đoạn hậu huấn luyện và Microsoft AI cho biết sẽ sớm công bố thêm kết quả. Hãng cũng đã bắt đầu chuẩn bị cho MAI-Base-3.
Các phép so sánh hiện chỉ dựa trên bộ đề nội bộ của Microsoft và chỉ gồm mô hình trọng số mở. MAI-Base-2 đứng ở đâu so với các mô hình độc quyền hàng đầu vẫn là câu hỏi bỏ ngỏ.
Thêm hanthienhai.com vào danh sách nguồn ưu tiên trên Google
